सारांश
PDF (Portable Document Format) अपनी क्रॉस-प्लेटफॉर्म विज़ुअल फिडेलिटी के कारण एक मानक बन गया है, किंतु इसका स्थिर लेआउट PDF दस्तावेज़ अनुवाद के लिए गंभीर चुनौतियाँ उत्पन्न करता है। पाठ निष्कर्षण की कठिनाई, स्वरूपण में विघटन तथा सामग्री का गड़बड़ हो जाना प्रमुख समस्याएँ हैं।यह लेख इन समस्याओं के मूल कारणों का गहन विश्लेषण प्रस्तुत करता है तथा DL.Translator जैसे नए युग के AI अनुवाद समाधानों के माध्यम से, कि कैसे इंटेलिजेंट लेआउट रीकंस्ट्रक्शन तकनीक द्वारा PDF अनुवाद में स्वरूपण अनुरक्षण की समस्या का बुनियादी समाधान संभव है, इसका अन्वेषण करता है।
PDF अनुवाद की मुख्य चुनौती: स्वरूपण निष्ठा बनाए रखना अत्यंत कठिन क्यों है?
PDF अनुवाद की समस्याओं का समाधान करने हेतु, सर्वप्रथम उसके प्रारूप की मौलिक विशेषताओं को समझना आवश्यक है।PDF का आविष्कार Adobe कंपनी द्वारा किया गया था; इसका प्रमुख उद्देश्य किसी भी डिवाइस पर दृश्य प्रस्तुति की पूर्ण एकरूपता सुनिश्चित करना था, न कि सामग्री संपादन में लचीलेपन की सुविधा देना।आप इसे एक डिजिटल 'स्नैपशॉट' के रूप में समझ सकते हैं, जो मुद्रण लेआउट को सटीकता से लॉक कर देता है।अधिक जानकारी के लिए आप PDF प्रारूप का आधिकारिक परिचय या संबंधित विश्वकोश देख सकते हैं।
यह प्रकार की डिज़ाइन अनुवाद प्रक्रिया में कई मुख्य चुनौतियाँ उत्पन्न करती हैः
- पाठ प्रवाह की ‘‘खंडितता’’: PDF में पाठ सामग्री प्रायः उन स्वतंत्र वर्ण ब्लॉकों के रूप में संग्रहित होती है, जो सटीक निर्देशांकों पर स्थित होते हैं, न कि सामान्यतः प्रयुक्त सतत पाठ प्रवाह में।इसके कारण, सीधा प्रतिलिपि बनाने या पाठ निकालने पर अनुक्रम त्रुटियां, शब्दों का आपस में जुड़ जाना, अथवा PDF अनुवाद में अक्षरगत विकृति जैसी समस्याएं उत्पन्न होना अत्यंत सामान्य है।
- विन्यास और सामग्री का पृथक्करण: दस्तावेज़ के लेआउट, शैली (जैसे तालिकाएँ, छवियां, फॉन्ट) और पाठ्य सामग्री को पृथक रूप से संग्रहित व प्रस्तुत किया जाता है।परंपरागत PDF अनुवाद उपकरण केवल पाठ स्तर का यांत्रिक प्रतिस्थापन करते हैं, जटिल लेआउट संबंधों को समझने और पुनर्निर्मित करने में असमर्थ रहते हैं, परिणामस्वरूप फॉर्मेटिंग पूरी तरह चरमरा जाती है।
- स्कैन-आधारित PDF की OCR बाधाएँ: स्कैन-आधारित PDF मूलतः चित्र फ़ाइलें होती हैं।अनुवाद से पूर्व, इनका ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) तकनीक द्वारा मशीन-पठनीय पाठ में रूपांतरण अनिवार्य है।यह मध्यवर्ती चरण स्कैन की गई PDF अनुवाद की अंतिम गुणवत्ता के लिए अत्यंत महत्वपूर्ण है।
AI अनुवाद का नया प्रतिमान: स्मार्ट लेआउट पुनर्निर्माण आधारित समाधान
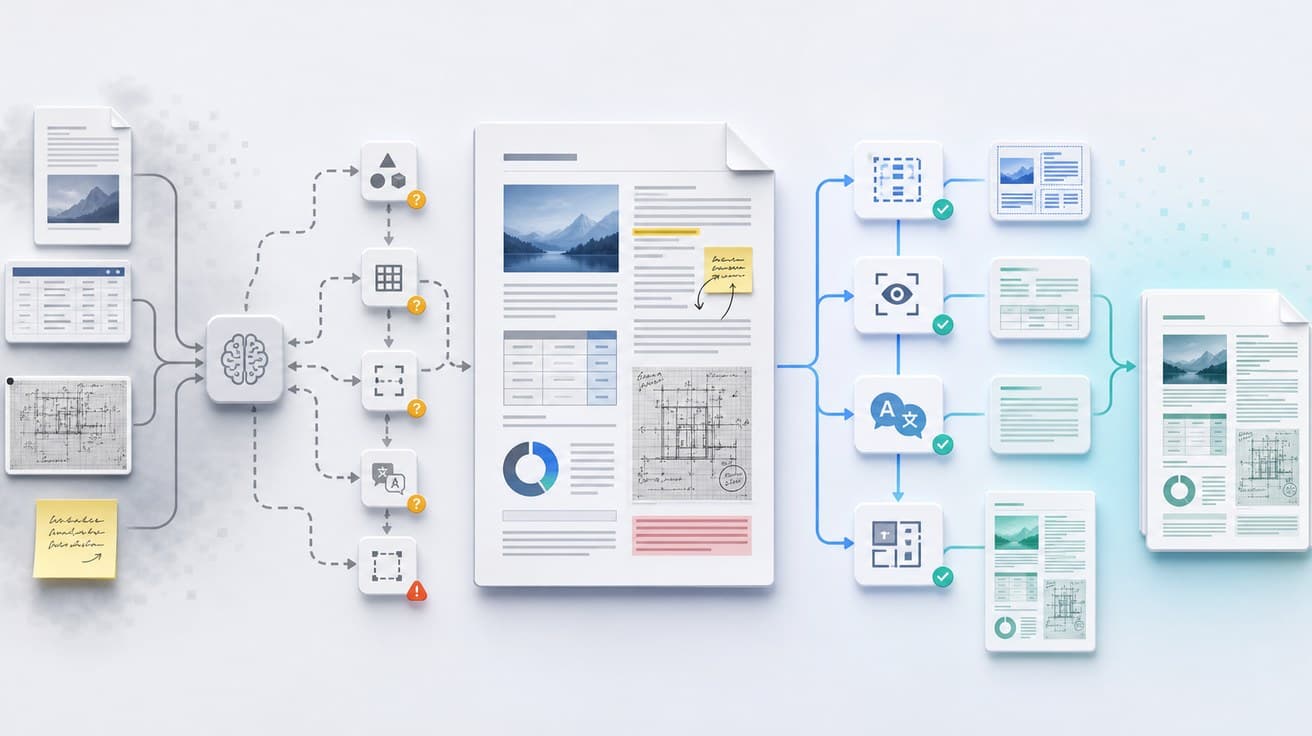
उपरोक्त चुनौतियों के समाधान के लिए, स्मार्ट लेआउट पार्सिंग और पुनर्निर्माण पर आधारित AI अनुवाद का नया प्रतिमान विकसित किया गया है।इस क्षेत्र में केंद्रित एक पेशेवर दस्तावेज़ अनुवाद उपकरण DL.Translator इसी तकनीक का अनुपालन करता है।हम PDF अनुवाद की समस्याओं को गहराई से समझते हैं, जिसकी मूलभूत तकनीक अब केवल “पाठ प्रतिस्थापन” नहीं है, बल्कि यह बुद्धिमान लेआउट विश्लेषण एवं पुनर्निर्माण है।
DL.Translator का इंजन PDF की जटिल दस्तावेज संरचना का बुद्धिमत्तापूर्वक विश्लेषण करने में सक्षम है, जो सामग्री स्तर, छवि स्तर और प्रारूप स्तर को सटीक रूप से विभेदित करता है।उच्च-गुणवत्ता वाले न्यूरल नेटवर्क अनुवाद के साथ, यह लगभग पिक्सेल-स्तरीय शुद्धता से मूल लेआउट का पुनर्निर्माण कर सकता है, जिससे पाठ, चित्र, तालिकाएँ और वेक्टर ग्राफिक्स तक उचित रूप से व्यवस्थित रहते हैं।
इस प्रकार का “विज़ुअल (What You See Is What You Get)” PDF अनुवाद अनुभव पारंपरिक उपकरणों द्वारा अनुवाद के बाद स्वरूप में उत्पन्न होने वाली गड़बड़ी की समस्या को मूल रूप से सुलझाता है। इसकी पृष्ठभूमि में निहित अनुवाद तकनीकी सिद्धांत, दस्तावेज़ संसाधन में एक महत्वपूर्ण प्रगति का द्योतक हैं।
PDF दस्तावेज़ अनुवाद की गुणवत्ता और कार्यकुशलता बढ़ाने हेतु व्यावसायिक रणनीतियाँ
उन्नत उपकरणों का उपयोग करते हुए, यदि पेशेवर कार्यप्रवाह को भी अपनाया जाए तो अनुवाद कार्य की उत्पादकता में उल्लेखनीय वृद्धि हो सकती है।
1. व्यावसायिक शब्दावली (Glossary) का निर्माण और अनुप्रयोग
तकनीकी पुस्तिकाओं, विधिक अनुबंधों, तथा शैक्षणिक रिपोर्टों जैसे व्यावसायिक दस्तावेज़ अनुवाद में, शब्दावली अनुवाद की एकरूपता अत्यंत महत्वपूर्ण है।शब्दावली फ़ंक्शन का उपयोग करते हुए, आप ब्रांड नाम, औद्योगिक शब्दों तथा विशिष्ट संज्ञाओं केएकरूप अनुवाद पूर्व निर्धारित कर सकते हैं।DL.Translator जैसे पेशेवर उपकरण अनुवाद के दौरान इन नियमों का कठोरता से पालन करते हैं, जिससे अनुवाद की विशेषज्ञता एवं शब्दावली की सुसंगतता सुनिश्चित होती है।
2. स्थानीयकरण (Localization) एवं सांस्कृतिक अनुकूलन पर ध्यान
अनुवाद केवल भाषा का रूपांतरण नहीं, बल्कि संस्कृति का अनुकूलन भी है।पेशेवर अनुवाद लक्षित बाज़ार की सांस्कृतिक प्रथाओं के अनुरूप होना चाहिए, जैसे तिथि प्रारूप, मुद्रा इकाइयाँ और माप प्रणाली का यथोचित रूपांतरण।कभी-कभी, एक शब्द की किसी अन्य सांस्कृतिक संदर्भ में पूरी तरह भिन्न व्याख्या हो सकती है।इन सूक्ष्मताओं की गहन समझ ही “विश्वसनीयता, अभिव्यक्ति और सौंदर्य” अनुवाद मानक के अनुपालन की कुंजी है।
3. संपादन योग्य स्रोत फ़ाइलों को प्राथमिकता दें
यदि संभव हो, तो आप अनुवाद के लिए मूल Word (.docx), Excel (.xlsx) या PowerPoint (.pptx) स्रोत फ़ाइलें प्राप्त कर सकते हैं। लेआउट संरक्षण फ़ाइल, फ़ॉन्ट और टेक्स्ट की लंबाई पर निर्भर करता है; जटिल तालिकाओं, स्कैन किए गए पृष्ठों और छवियों में टेक्स्ट की मैन्युअल समीक्षा की आवश्यकता हो सकती है। पूर्ण दस्तावेज़ का अनुवाद करने से पहले आंशिक पूर्वावलोकन जांचें।विभिन्न दस्तावेज़ अनुवाद रणनीतियों की समझ, आपको विशेष स्थिति के अनुसार सर्वोत्तम समाधान चुनने में सक्षम बनाती है, जिससे कार्यक्षमता में उल्लेखनीय वृद्धि हो सकती है।
निष्कर्ष: तकनीकी सशक्तिकरण द्वारा PDF अनुवाद की “प्रारूप बाधा” को पार करना
PDF का स्वरूप-जनित अवरोध अंतर्राष्ट्रीय दस्तावेज़ कार्यप्रवाह में कभी एक मुख्य चुनौती रहा है।DL.Translator के प्रतिनिधित्व में स्मार्ट लेआउट पुनर्निर्माण तकनीक के विकास के साथ, प्रारूप को सटीक रूप से संरक्षित रखते हुए PDF अनुवाद अब संभव हो गया है।इससे पेशेवरों को जटिल पश्च-प्रक्रिया लेआउट समायोजन से मुक्ति मिलती है तथा वे अपने प्रयासों को वास्तव में मूल्यवान सामग्री की समीक्षा और अनुकूलन पर केंद्रित कर सकते हैं।
> DL.Translator आधिकारिक वेबसाइट पर जाएँ, और मूल प्रारूप को संरक्षित रखने वाले AI दस्तावेज़ अनुवाद का अनुभव प्राप्त करें।
गहन अध्ययन
संदर्भ: PDF अनुवाद के लिए नई स्वर्ण मानक, DL.Translator पारंपरिक PDF अनुवाद की तुलना में किस प्रकार उत्कृष्ट है, इसका विश्लेषण।